Research·
تخصص المفردات يقلل تكلفة استدلال النماذج اللغوية الصغيرة بنسبة 77%
تعيد طريقة VocabX من Dharma-AI بناء المحللات اللغوية حول تكلفة كل رمز بدلاً من تكراره، مما يقلل بشكل كبير نفقات الاستدلال للنماذج اللغوية الصغيرة المتخصصة دون إعادة تدريب النموذج الأساسي.
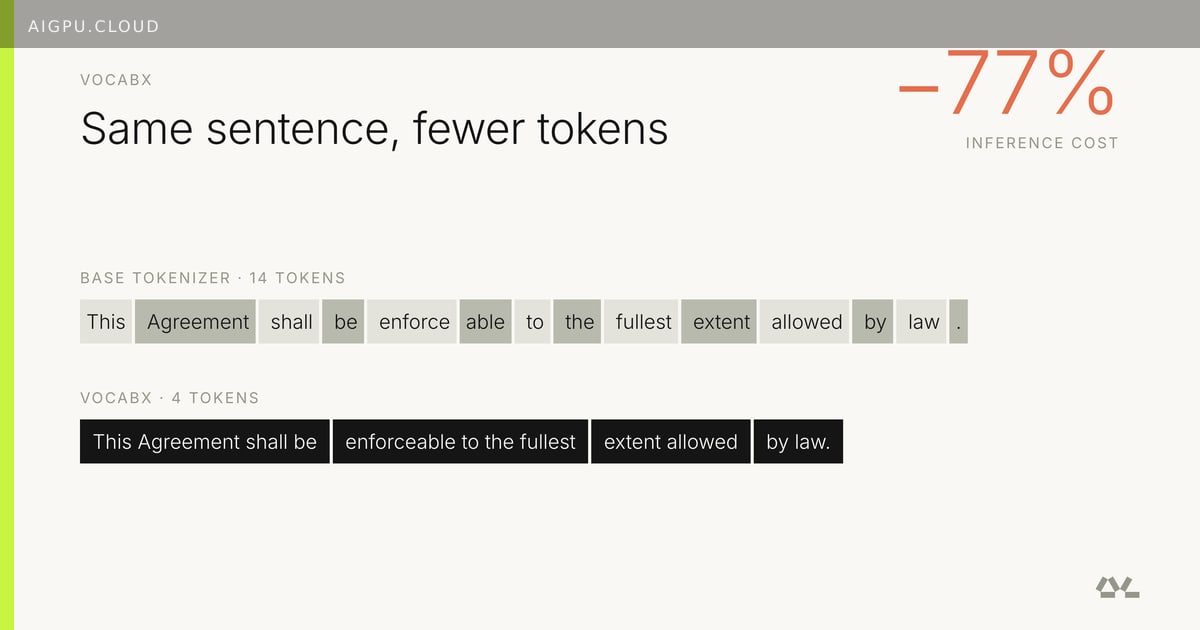
غالباً ما ترث النماذج اللغوية الصغيرة المضبوطة لمجال واحد محللاً لغوياً عاماً يضخم تكاليف الاستدلال بطريقتين. أولاً، يقسم المحلل الأنماط المتكررة في المجال — مثل أظرف JSON، والبنود النمطية، أو معرفات الكود — إلى العديد من الرموز حيث يكفي رمز واحد. ثانياً، يحسب النموذج احتمالات لعشرات الآلاف من إدخالات المفردات التي لن يستخدمها أبداً، مثل الحروف الصينية عند تصحيح المقالات البرتغالية.
VocabX: تصميم مفردات يراعي التكلفة
قدم فريق Dharma-AI طريقة VocabX، التي تعيد بناء المفردات حول التكلفة المقاسة لكل رمز بدلاً من تكراره الخام. عند تطبيقها على نموذج Qwen3-4B لتصحيح المقالات البرتغالية، قلل المحلل اللغوي المتخصص المفردات من 151,669 إدخالاً إلى مجموعة فرعية تركز على المجال مع الحفاظ على النموذج الأساسي، وبيانات التدريب، والوصفة دون تغيير. انخفضت تكلفة الاستدلال المقاسة بنسبة 77% في الإنتاج.
بالنسبة لمشغلي سحابة GPU وفرق البنية التحتية للذكاء الاصطناعي، تسلط هذه النتيجة الضوء على رافعة مهملة غالباً: تحسين المحلل اللغوي قبل أي خطوة تدريب. مفردات أصغر ومتوافقة مع المجال تقلل من عبء توليد الرموز وضرب المصفوفات في الطبقة النهائية في كل خطوة فك ترميز، مما يقلل مباشرة ساعات GPU لكل طلب.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- vocabx
- tokenizer optimization
- slm inference
- gpu cost reduction
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Hugging Face Blog)
→ كل المقالات