Industry·
سونو تتوسع إلى ما وراء الموسيقى بتوليد موحد للصوت والموسيقى
أطلقت منصة الموسيقى الذكية سونو ميزة Speech التجريبية التي تُنشئ سرداً صوتياً وموسيقى خلفية في مسار واحد، مستهدفة المبدعين الذين يحتاجون إلى صوت متماسك للبودكاست والفيديو والتجارب التفاعلية.
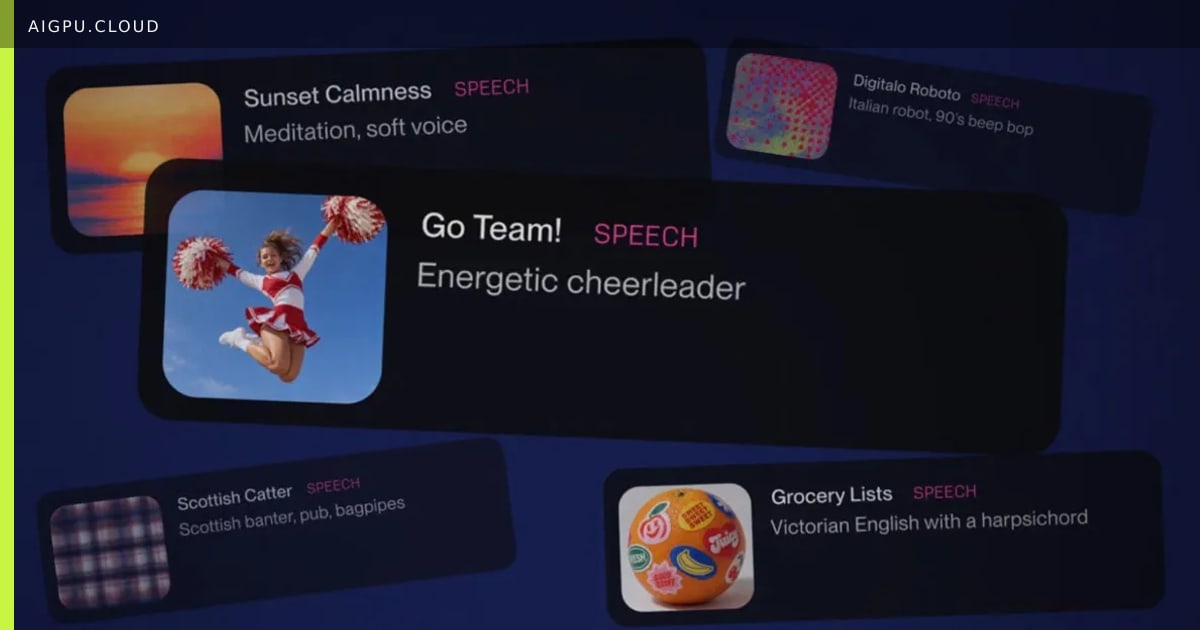
أطلقت سونو، المعروفة بنماذجها التوليدية للموسيقى، ميزة Speech — وهي قدرة تجريبية تُنشئ تعليقات صوتية وتضيف إليها موسيقى مؤلفة بالذكاء الاصطناعي اختيارياً. يمكن للمستخدمين اختيار وضع المطالبة البسيط أو وضع النص المتقدم، وضبط جنس الصوت وأسلوبه وتنوعه، وإنشاء مقاطع تصل مدتها إلى ثماني دقائق.
لماذا هذا مهم للبنية التحتية لوحدات معالجة الرسوميات والذكاء الاصطناعي
توليد الصوت والموسيقى معاً يضاعف عبء الاستدلال مقارنة بنماذج تحويل النص إلى كلام أو نماذج الموسيقى المنفصلة، مما يتطلب عرض نطاق ذاكرة GPU أعلى وقدرة حسابية مستمرة للبث في الوقت الفعلي. مزودو السحابة الذين يقدمون عناقيد GPU قابلة للتوسع للذكاء الاصطناعي — مثل AiGpu — يمكنهم تسريع تكرار النماذج، وتقليل زمن الاستجابة للتطبيقات التفاعلية، ودعم الطلب المتزايد على خطوط أنابيب الصوت متعددة الوسائط.
الميزة لا تزال في مراحلها الأولى؛ تعترف سونو بانحراف اللهجات أحياناً وتوقفات مبالغ فيها. ستؤدي ملاحظات المستخدمين المستمرة إلى تحسين سريع للنماذج، وهي دورة تستفيد من موارد GPU المرنة لإعادة التدريب المتكرر واختبارات A/B.
بالنسبة للمؤسسات التي تبني منتجات مدعومة بالصوت — من سرد التعليم الإلكتروني إلى حوارات الألعاب الديناميكية — فإن القدرة على إنتاج مسارات موسيقية متطابقة في استدعاء واحد تبسط سير العمل وتقلل تكاليف الترخيص، مما يجعل الصوت التوليدي المتكامل ميزة استراتيجية.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- suno
- speech synthesis
- generative audio
- voice ai
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (The Verge AI)
→ كل المقالات