Infrastructure·
تحليل أداء TorchNeuron على شريحة AWS Trainium: رؤى على مستوى النظام لتسريع الاستدلال
تعرّف على كيفية التقاط وتحليل التتبعات على مستوى النظام على شريحة AWS Trainium باستخدام واجهة TorchNeuron الأصلية لـ PyTorch، و NeuronConfig، و Neuron Explorer.
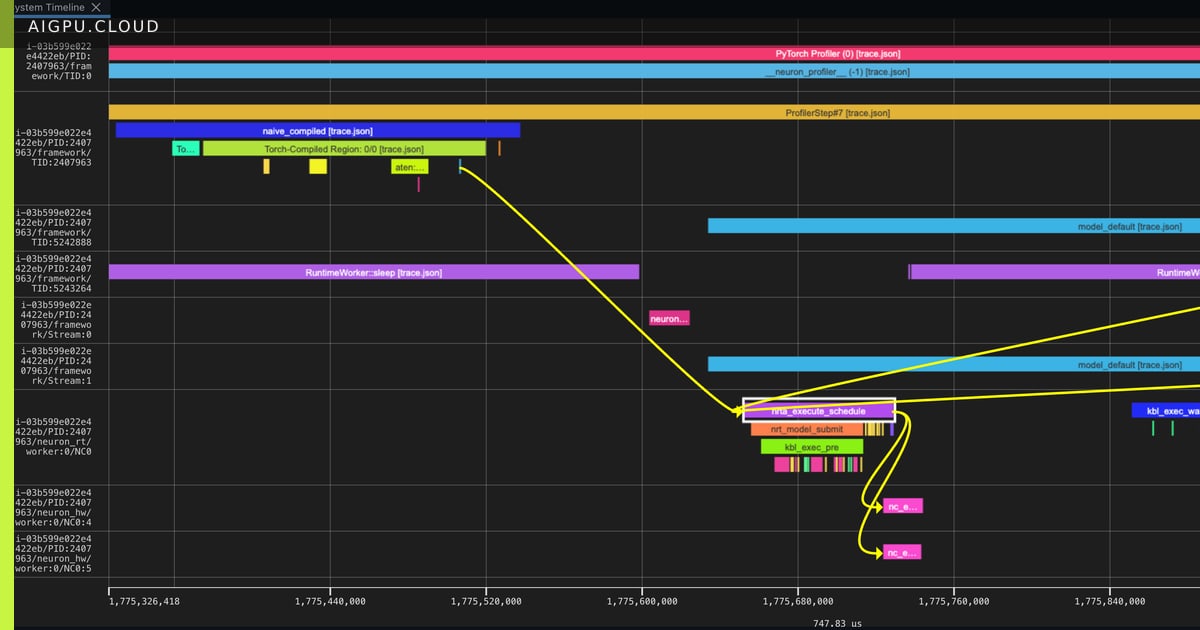
يُعد التحليل الدقيق للأداء الخطوة الأولى لتحويل نموذج بطيء إلى خدمة جاهزة للإنتاج. يوضح هذا الدليل كيفية قياس عبء عمل TorchNeuron على شريحة AWS Trainium دون الحاجة إلى خبرة سابقة في التحليل.
يسجل TorchNeuron نفسه كخلفية أصلية لـ PyTorch عبر نقطة تمديد PrivateUse1، مما يتيح تنفيذ الوضع المتشوق (eager)، و torch.compile، ونواة NKI المخصصة للعمل دون تعديل على أجهزة Trainium.
لبدء التحليل، يتم إنشاء NeuronConfig يحدد تدفقات الجهاز والوقت التشغيلي، ويختار NeuronCores المراد تتبعها، ويُمكّن ربط وقت الجهاز. يُمرر هذا الإعداد إلى torch.profiler.profile ويُغلف التشغيل بـ NeuronProfiler الذي يكتب ملف trace.json موحداً إلى جانب ملفات .neff/.ntff المطابقة.
key_averages() مع الخط الزمني الرسومي لتحديد الدورات الدقيقة التي تستهلكها NeuronCore.لماذا هذا مهم للبنية التحتية للذكاء الاصطناعي
فهم اختناقات مستوى الجهاز يتيح للفرق اختيار حجم مثالي لمثيلات Trainium، وتحسين اختيار النواة، وتقليل زمن استجابة الاستدلال — أمر جوهري لأي منصة سحابية تعتمد على معالجات GPU أو مسرعات AI وتعد بأداء قابل للتنبؤ على نطاق واسع.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- trainium
- torchneuron
- profiling
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Hugging Face Blog)
→ كل المقالات