Infrastructure·
تحليل أداء TorchNeuron على AWS Trainium: دليل مستوى النظام لمهندسي الذكاء الاصطناعي
تعلم كيفية تحليل وتحسين أعباء عمل PyTorch على AWS Trainium بشكل منهجي باستخدام أدوات التحليل الأصلية في TorchNeuron و Neuron Explorer.
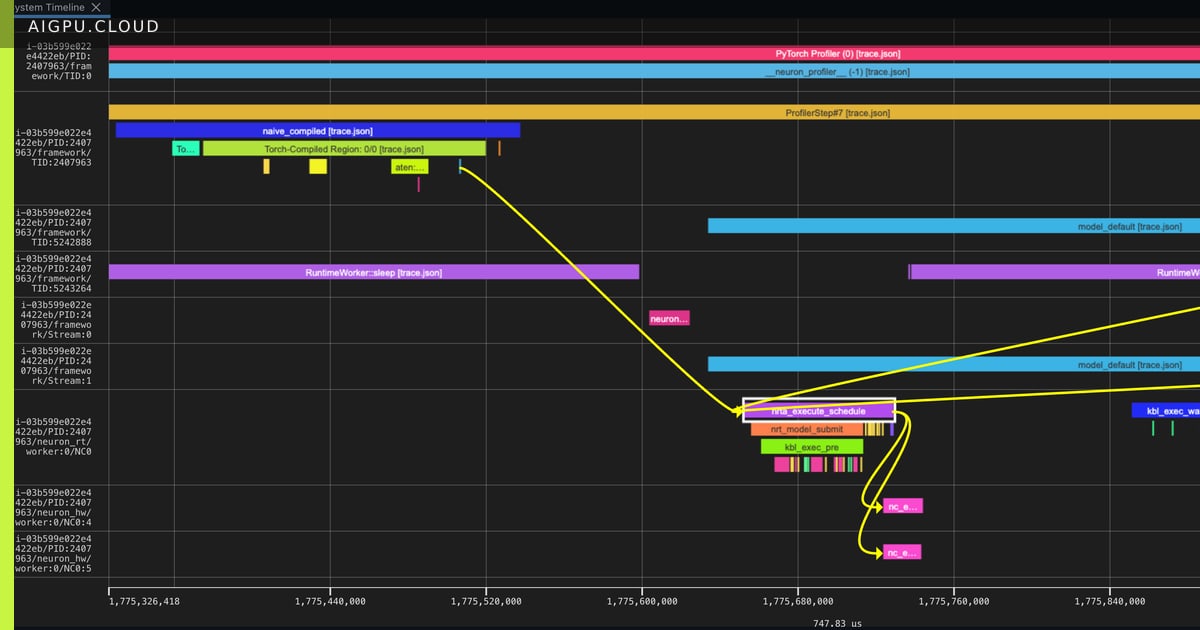
برزت AWS Trainium كبديل مقنع للتدريب والاستدلال في التعلم العميق، لكن استخراج الأداء الأقصى يتطلب رؤية في مكان إنفاق دورات الحوسبة فعليًا. يرشد الجزء الأول من سلسلة التحليل في Hugging Face المهندسين خلال سير عمل عملي بدون افتراضات مسبقة لأدوات TorchNeuron باستخدام torch.profiler والخلفية العصبية (Neuron backend).
من إرسال الإطار (Framework Dispatch) إلى تنفيذ NeuronCore
يوضح الدليل كيف تلتقط NeuronConfig و NeuronProfiler تعليمات الجهاز، وجدولة وقت التشغيل، وإرسال الإطار في تتبع واحد. من خلال تمكين correlate_device_time، يعرض جدول key_averages() الناتج كلًا من وقت CPU ووقت جهاز Neuron جنبًا إلى جنب، مما يسهل اكتشاف العمليات التي تتوقف على المضيف مقابل تلك التي تشبع المعجل.
يتيح Neuron Explorer للفرق التعمق من خط زمني عالي المستوى إلى تفصيل لكل محرك على NeuronCores الفردية، مؤكدًا النتائج العددية بأدلة مرئية. يوضح المنشور كيف تنقل ثلاث تطبيقات للعملية نفسها — التنفيذ المباشر (eager)، و torch.compile، ونواة NKI مخصصة — ملف الاختناق (bottleneck profile) بطرق قابلة للقياس.
لماذا هذا مهم لبنية GPU/الذكاء الاصطناعي التحتية: مع تنويع المؤسسات بعيدًا عن CUDA، فإن القدرة على تحليل المعجلات المبنية لغرض مثل Trainium باستخدام أدوات PyTooling المألوفة تقلل من احتكاك الإعداد وتسرع وقت التحسين. تعني واجهات التحليل القياسية أن مهارات هندسة الأداء تنتقل عبر منصات الأجهزة، وهو اعتبار رئيسي لاستراتيجيات الذكاء الاصطناعي متعددة السحابات.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- trainium
- torchneuron
- profiling
- aws
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Hugging Face Blog)
→ كل المقالات