Industry·
تقدّم NVIDIA وAI4Bharat بمجموعة بيانات للغات الهندية بحجم 2.8 طريقة من الأحرف مع خط أنابيب GPU مفتوح
تقدّم شراكة بين NVIDIA ومختبر AI4Bharat في الهند بمجموعة بيانات مفتوحة ضخمة للغات الهندية المؤلفة من 22 لغة، مدعومة بخط أنابيب لتوليد البيانات مُحسّن للـ GPU.
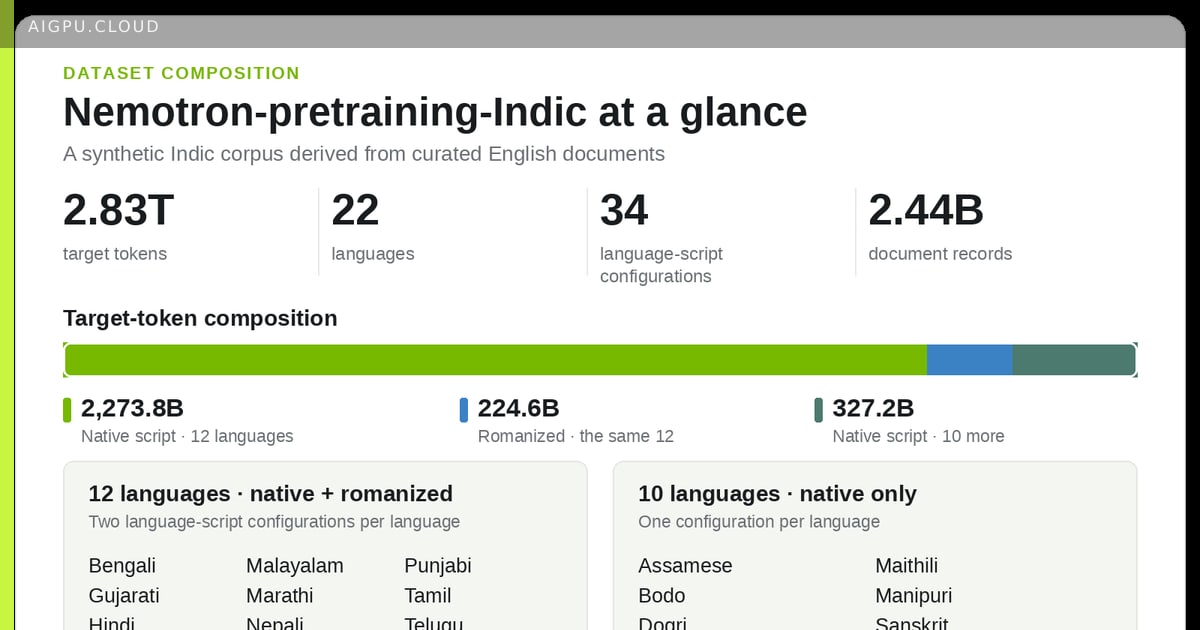
عقدت شركة NVIDIA مع مختبر AI4Bharat في الهند إطلاق مبادرة ثورية لدعم تطوير الذكاء الاصطناعي باللغات الهندية من خلال مجموعة بيانات ضخمة وبنية تحتية مفتوحة المصدر. تقدّم هذه الشراكة مجموعة بيانات تُسمّّى Nemotron-pretraining-Indic-v1، والتي تشمل حوالي 2.8 طريقة من الأحرف عبر 22 لغة هندية معترف بها في دستور الهند، مغطية لـ 97% من السكان.
تجمع المجموعة بين المحتوى المكتوب بالخط الوثقي الأصلي لجميع اللغات الـ 22، ونصوصًا رومانية لـ 12 لغة، مدعومة بـ 34 تكوينًا لغويًا. تم بناء هذه البيانات باستخدام خط أنابيب مُحسّن للـ GPU، يشمل ترجمة المستندات، وتقييم الجودة، وسير عمل إصلاح موجه، مما يضمن بقاء النصوص الاصطناعية مرتبطة بالمصادر المُنظّمة مع الحفاظ على العناصر التقنية مثل المعادلات والكود.
تتضمن ميزات رئيسية في الخط أنابيب التوثيق الكامل لإعادة الإنتاج، مع مشاركة المطورين للمواد النصية والمسارات اللوجستية وتحقق الجودة مفتوحة. يمكن للمطورين تعديل الإطار لاستخدام مصادرهم الخاصة أو الاستفادة من المجموعة مباشرةً لتدريب نماذج قادرة على شرح المفاهيم التقنية وحل المشكلات باللغات الهندية.
لماذا يهم هذا في بنية تحتية GPU / الذكاء الاصطناعي؟ تُبرز هذه الإطلاع أهمية موارد GPU القابلة للتوسع في توليد البيانات الاصطناعية للغات غير الممثلة بكثرة. يتيح الخط الأنابيب المفتوح لمزودي الخدمة السحابية نسخة وتوسيع العملية، مما يقلل الحواجز لبناء نماذج لغات هندية ذات جودة عالية، بينما يعزز استغلال GPU لمهام الترجمة وضمان الجودة.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- indic languages
- gpu pipeline
- nvidia
- ai training data
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Hugging Face Blog)
→ كل المقالات