Industry·
LiquidAI تطلق نماذج قرار d1 مفتوحة محسّنة للنشر على الحافة
تكشف LiquidAI عن نموذجين d1-3B و d1-omni-600M، نماذج قرار متعددة الوسائط تحقق استدلالًا بأقل من 50 مللي ثانية على أجهزة NVIDIA Jetson، مما يضع معايير جديدة لاتخاذ القرار بالذكاء الاصطناعي على الحافة.
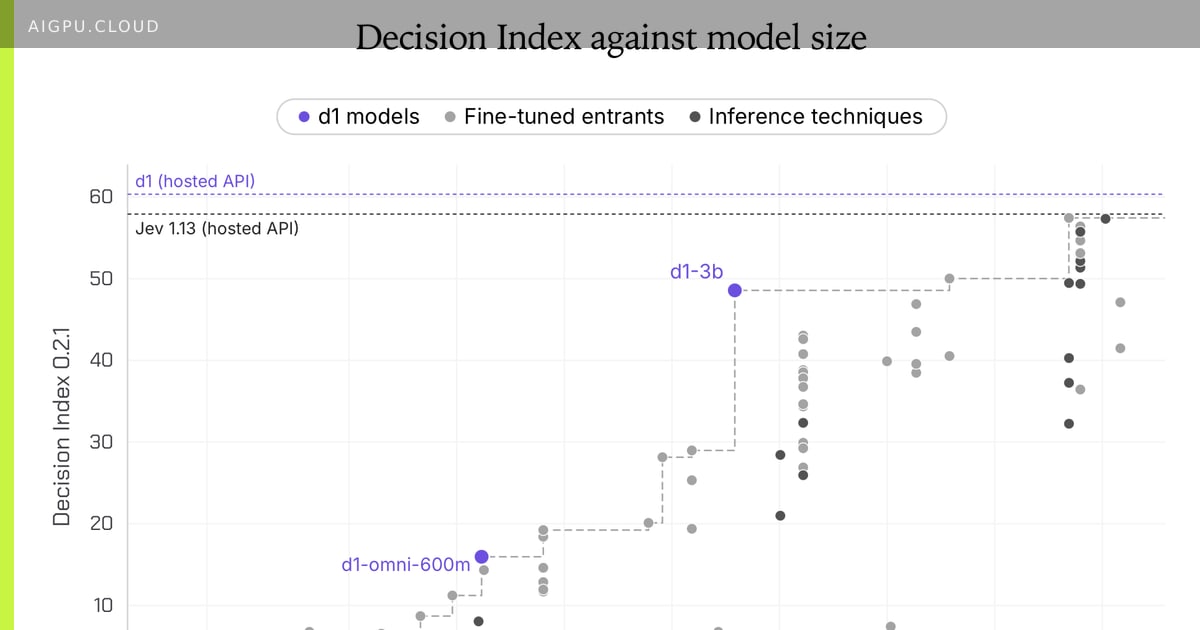
أصدرت LiquidAI نموذجين للقرار ضمن عائلة d1 الجديدة: نموذج d1-3B بثلاثة مليارات معامل، والنموذج التجريبي d1-omni-600M بـ 600 مليون معامل. على عكس نماذج LLM التوليدية التي تصدر الرموز بشكل متسلسل، تنتج هذه النماذج قرارًا في تمريرة أمامية واحدة، مما يجعلها مصممة خصيصًا لأعباء العمل الحساسة للزمن على الحافة مثل الروبوتات، والفحص الصناعي، وإدارة المحتوى في الوقت الفعلي.
على مؤشر القرار 0.2.1، حقق d1-3B درجة 48.57، متفوقًا على كل خطوط الأساس 4B و 9B وحتى نموذج Decider 35B-A3B ذو 35 مليار معامل (47.11). عبر سبعة معايير عامة تغطي فهم القراءة، وكشف السمية، وتصنيف النية، والأسئلة الطبية، والفهم متعدد اللغات، بلغ متوسط d1-3B درجة 82.9 بينما حقق d1-omni-600M الصغير متوسط 78.4 — متجاوزًا Decider 2B بربع المعاملات فقط.
متعدد الوسائط من الأساس
يرث d1-3B قدرة الرؤية واللغة من هيكل LFM2.5-VL-3B فك التشفير، مقبلًا النصوص والصور. أما d1-omni-600M التجريبي فيبني على نواة LFM2.5-Encoder-350M ثنائية الاتجاه ويضيف مشفرات منفصلة للرؤية والصوت، مما يمكّن أزواج إدخال نص-صورة أو نص-صوت. تحافظ هذه المعمارية على بصمة نموذج صغيرة بينما تغطي ثلاث وسائط — تركيبة نادرة في فئة أقل من 1B.
بالتعاون مع NVIDIA، قاست LiquidAI أداء d1-3B على كامل مجموعة Jetson. بلغ زمن الاستعلام الواحد 16 مللي ثانية على AGX Thor، و 26 مللي ثانية على AGX Orin 64 GB، و 50 مللي ثانية على Orin Nano. إضافة استعلامين إضافيين تزيد الزمن بنسبة ~20 % فقط، وتضيف صورة 384 بكسل حوالي 20 مللي ثانية على Thor. على RTX 4090، يحل نفس الاستعلام في 8 مللي ثانية. تُظهر هذه الأرقام أن استدلال القرار عالي الجودة لم يعد يتطلب وحدات GPU في مراكز البيانات.
لماذا يهم هذا البنية التحتية لـ GPU / الذكاء الاصطناعي: نماذج القرار التي تعمل بأجزاء من المللي ثانية على وحدات Jetson المدمجة تغير اقتصاديات الذكاء الاصطناعي على الحافة. يمكن للفرق الآن نشر استدلال حتمي متعدد الوسائط على أساطيل NVIDIA الحالية على الحافة دون توفير احتياطي سحابي، مما يقلل عرض النطاق، والكمون، والتكلفة التشغيلية للأتمتة في الوقت الفعلي.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- edge ai
- decision models
- liquidai
- nvidia jetson
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Hugging Face Blog)
→ كل المقالات