Models·
تسريع نماذج الرؤية-اللغة باستخدام LFM2.5-VL-DSpark
قدمت LiquidAI نموذج LFM2.5-VL-DSpark التجريبي، المصمم لتسريع نماذج الرؤية-اللغة (VLMs) بشكل كبير من خلال فك التشفير التخميني. يعد هذا الابتكار بسرعة استدلال أعلى دون المساومة على جودة المخرجات، مما يجعل الذكاء الاصطناعي المتقدم أكثر سهولة وكفاءة.
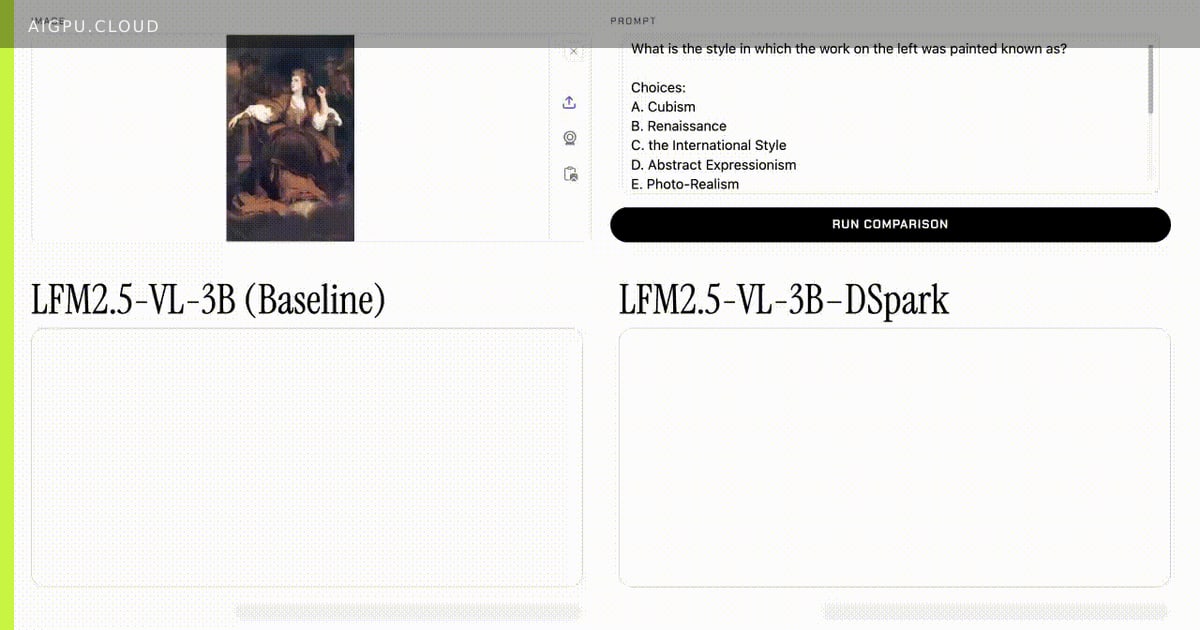
LiquidAI تكشف عن LFM2.5-VL-DSpark لتحسين أداء نماذج الرؤية-اللغة
أعلنت LiquidAI عن إطلاق LFM2.5-VL-DSpark، وهو نموذج مسودة تجريبي يهدف إلى تحسين سرعة الاستدلال لنموذج الرؤية-اللغة LFM2.5-VL-3B بشكل كبير. يستفيد هذا التطور الجديد من فك التشفير التخميني، وهي تقنية تقدم نموذجًا ثانويًا أصغر (المسودة) للتنبؤ بالرموز القادمة، والتي يتم التحقق منها بعد ذلك بواسطة النموذج الرئيسي. تتيح هذه الطريقة تسريعًا كبيرًا مع الحفاظ على دقة مخرجات النموذج الأصلي.
يمثل نموذج المسودة LFM2.5-VL-DSpark، الذي يبلغ حوالي 280 مليون معلمة، زيادة متواضعة بنسبة 8.9% في العدد الإجمالي للمعلمات. على الرغم من هذا الحمل الزائد الضئيل، فإن المكاسب في الأداء كبيرة. أظهرت الاختبارات المعيارية على وحدة معالجة الرسوميات H100 تسريعًا في فك التشفير يصل إلى 2.66 مرة، مع تحسينات في الاستدلال من البداية إلى النهاية تصل إلى 2.27 مرة. وعلى الأجهزة الطرفية مثل M5 Max، شهدت سرعات فك التشفير زيادة تصل إلى 3.13 مرة، وتحسنت زمن الاستجابة من البداية إلى النهاية بنسبة تصل إلى 2.62 مرة.
أحد الجوانب الرئيسية لهذا الابتكار هو توافقه الواسع. فقد ضمنت LiquidAI دعمًا فوريًا لأطر عمل الاستدلال الشائعة، بما في ذلك llama.cpp وMLX-VLM وSGLang. يبسط هذا التكامل عملية النشر ويسمح للمطورين بالاستفادة فورًا من الأداء المتسارع عبر مختلف تكوينات الأجهزة، من وحدات معالجة الرسوميات في مراكز البيانات إلى الأجهزة الاستهلاكية.
بينما يوفر فك التشفير التخميني مزايا كبيرة لمرحلة فك التشفير، يمكن أن يكون تأثيره على الأداء العام لنموذج الرؤية-اللغة مقيدًا بعوائق حسابية أخرى. على وجه التحديد، فإن مراحل تشفير الرؤية الأولية ومرحلة التعبئة المسبقة، والتي يمكن أن تكون كثيفة الحوسبة، خاصة على الأجهزة الطرفية، لا يتم تسريعها مباشرة بهذه الطريقة. وبالتالي، فإن التسريع من البداية إلى النهاية يخضع لقانون أمدال، مما يعني أن التحسين الكلي محدود بالأجزاء غير المعجلة من سير العمل.
لماذا يهم هذا للبنية التحتية لوحدات معالجة الرسوميات / الذكاء الاصطناعي
يعد هذا التقدم حاسمًا لمقدمي البنية التحتية لوحدات معالجة الرسوميات والذكاء الاصطناعي. فسرعة الاستدلال الأكبر تترجم مباشرة إلى إنتاجية أعلى وتكاليف تشغيل أقل لنشر نماذج الذكاء الاصطناعي واسعة النطاق. بالنسبة لمنصات سحابة وحدات معالجة الرسوميات، يعني تحسين أداء نماذج الرؤية-اللغة استخدامًا أكثر كفاءة للأجهزة باهظة الثمن مثل H100، مما يمكن العملاء من تشغيل مهام أكثر تعقيدًا أو خدمة عدد أكبر من المستخدمين بنفس الموارد. علاوة على ذلك، يؤكد التركيز على التوافق مع أطر العمل المتنوعة على الحاجة إلى بنية تحتية مرنة وعالية الأداء يمكنها الاندماج بسلاسة مع أحدث تقنيات تسريع الذكاء الاصطناعي.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- vision-language models
- speculative decoding
- gpu acceleration
- ai inference
- h100
- edge ai
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Hugging Face Blog)
→ كل المقالات