Research·
طريقة HOPE من أمازون تعيد تعريف تقليم الخبراء في نماذج خليط الخبراء
تحافظ تقنية التقليم من الدرجة الثانية المسماة HOPE على مجموعات الخبراء التعاونية في نماذج MoE، محققة مكاسب تصل إلى 6.1% في معايير البرمجة عند 50% من الندرة — أمر حاسم لتقليل ضغط ذاكرة GPU في الإنتاج.
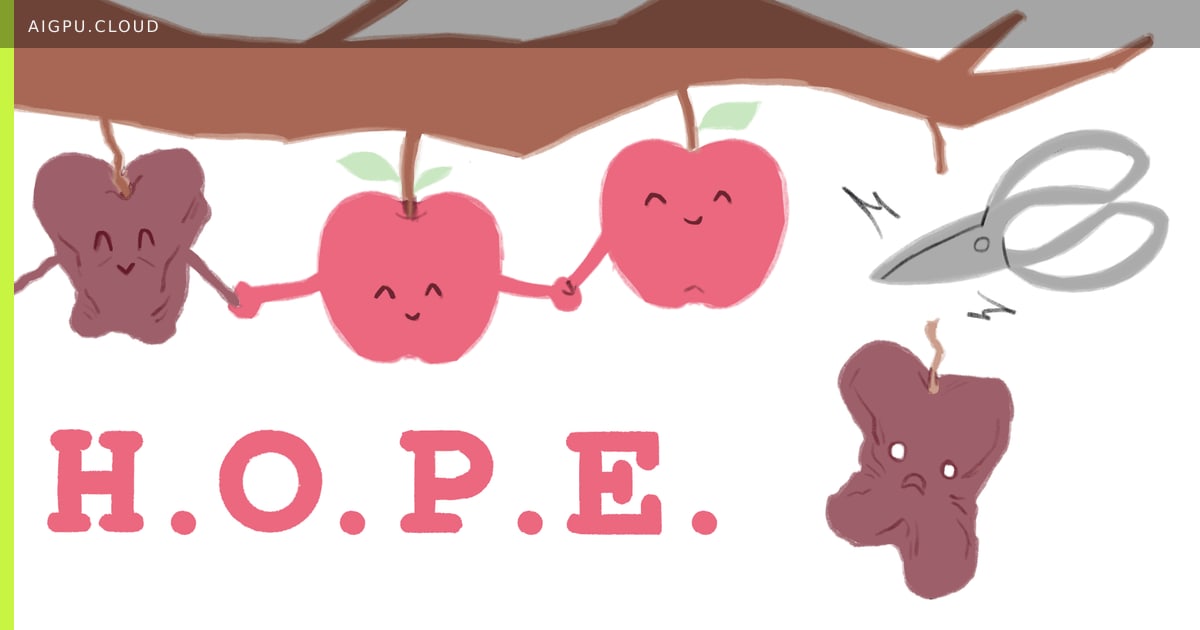
أطلقت معماريات خليط الخبراء (MoE) العنان للنماذج ذات تريليونات المعاملات، لكنها تفرض ضريبة ذاكرة باهظة: يجب أن يقيم كل MLP خبير في VRAM حتى لو ظل 90%+ منها خاملة لكل توكن. يقدم باحثو أمازون، عبر نشرهم في Hugging Face، طريقة HOPE — تقليم الخبراء من الدرجة العليا — وهي طريقة تتجاوز تقييم الأهمية المستقل لنمذجة التفاعلات الثنائية بين الخبراء.
يقوم التقليم التقليدي من الدرجة الأولى بترتيب كل خبير على حدة، ثم التخلص من الأقل تقييمًا. يتجاهل ذلك حقيقة موثقة: يشكل الخبراء مجموعات تنشيط مشترك مستقرة. تؤدي إزالة عضو من مجموعة تعاونية إلى تدهور أداء البقية. تحسب HOPE مصفوفة تفاعل من الدرجة الثانية على مجموعة معايرة، ثم تحل مشكلة اختيار توافقي تحافظ على الأزواج عالية التآزر معًا.
لماذا هذا مهم للبنية التحتية لـ GPU / الذكاء الاصطناعي
عند إزالة 50% من الخبراء، تضاهي HOPE أو تتفوق على الخطوط الأساسية الكثيفة عبر مهام الاستدلال والرياضيات والبرمجة الوكيلة — محققة مكاسب تصل إلى 6.1% على أفضل طريقة تقليم تالية في مهام البرمجة. لفرق البنية التحتية، هذا يترجم مباشرة إلى بصمات نماذج أصغر، وضغط أقل على KV-cache، وإنتاجية أعلى لكل GPU دون إعادة تدريب. تتوافق الطريقة بسلاسة مع الكمية وتتطلب فقط بضع آلاف من توكنات المعايرة.
أصدرت أمازون تطبيقات مرجعية لعائلات MoE من LLaMA و Qwen. يجب على الفرق التي تشغل أعباء عمل MoE كبيرة على عناقيد H100 أو B200 تقييم HOPE كخطوة ضغط جاهزة للاستخدام قبل خطوط أنابيب الكمية.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- moe
- model-pruning
- llm-optimization
- gpu-memory
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Hugging Face Blog)
→ كل المقالات