Industry·
أوبن أيه آي تطلق ميزة الإملاء المباشر في تشات جي بي تي مع تسجيل غير محدود
أصبح تشات جي بي تي ينسخ الكلام في الوقت الفعلي، وأزال حد العشر دقائق، وطرح الميزة على جميع المنصات — مما يشير إلى تزايد الطلب على استدلال صوتي منخفض الكمون على نطاق واسع.
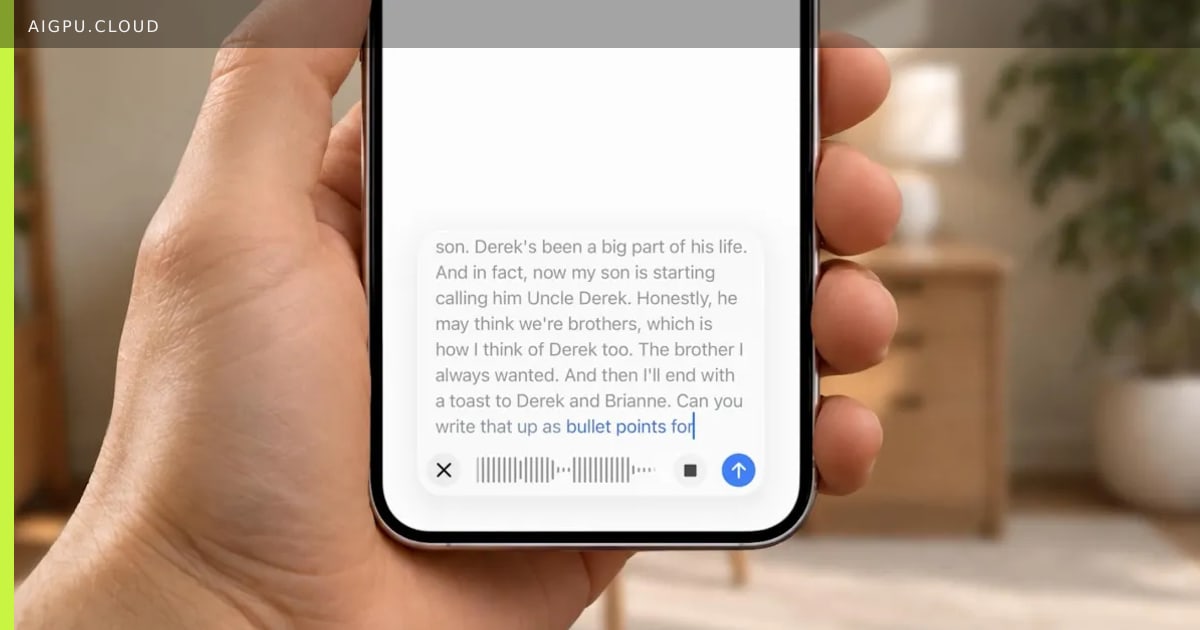
أطلقت أوبن أيه آي ميزة الإملاء المباشر (Live Dictation) في تشات جي بي تي، مما يتيح للمستخدمين نطق أوامرهم ورؤية النص يظهر كلمة بكلمة أثناء الحديث. أزالت التحديثة سقف التسجيل السابق البالغ 10 دقائق، وهي متاحة على كل المستويات — المجانية، بلس، تيم، إنتربرايز، وإيديو — عبر الويب، وسطح المكتب، والتطبيقات المحمولة.
النسخ في الوقت الفعلي يغير نموذج التفاعل
بدلاً من تسجيل مقطع، وانتظار الرفع، ثم استلام النص، تعرض واجهة الموجة الصوتية الرموز (tokens) فوراً في مربع الأوامر. يمكن للمستخدمين تعديل النص المباشر قبل تأكيده، مما يحول الصوت إلى نمط إدخال أساسي بدلاً من ميزة راحة ثانوية.
أشارت أوبن أيه آي أيضاً إلى تحسينات في الموثوقية خلف الكواليس. يأتي هذا التغيير بعد إصلاح وضع الصوت ثنائي الاتجاه في تشات جي بي تي في وقت سابق من هذا العام، ويجلس بجانب "وضع التسجيل" التجريبي لنسخ الاجتماعات، والذي لا يزال مقصوراً على مساحات العمل المدفوعة.
لماذا يهم هذا البنية التحتية للـ GPU / الذكاء الاصطناعي
يتطلب النسخ الصوتي المتدفق على نطاق المستهلك استدلالاً مستمراً منخفض الكمون على عناقيد GPU — خاصة عندما يجب أن تبقى ملايين الجلسات المتزامنة تحت 200 ميلي ثانية من طرف إلى طرف. تشغل كل جلسة إملاء مباشر مثيل نموذج مستمر، مما يدفع كثافة حسابية مستمرة بدلاً من أعباء عمل دفعة متقطعة. لمزودي السحابة ومشترين الأجهزة، يشير هذا إلى تحول نحو خطوط أنابيب صوتية دائمة تفضل وحدات GPU عالية الإنتاجية وفعالة في الذاكرة، ومكدسات خدمة محسنة (TensorRT-LLM، vLLM، نوى مخصصة). يجب أن تأخذ تخطيط السعة الآن في الاعتبار حركة الصوت المستمرة جنباً إلى جنب مع أعباء الدردشة والبرمجة التقليدية.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- openai
- speech-to-text
- gpu inference
- real-time ai
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (The Verge AI)
→ كل المقالات