Infrastructure·
بث نماذج خليط الخبراء من قرص SSD: 180 مليار معامل على 32 جيجابايت ذاكرة
تتيح تقنية بث الخبراء الجديدة تشغيل نموذج MoE بحجم 180 مليار معامل على وحدة معالجة رسوميات واحدة بسعة 32 جيجابايت، مع إبقاء الخبراء النشطين فقط في ذاكرة VRAM وسحب الباقي من تخزين سريع، مما يقلص الفجوة مع محركات الاستدلال المخصصة.
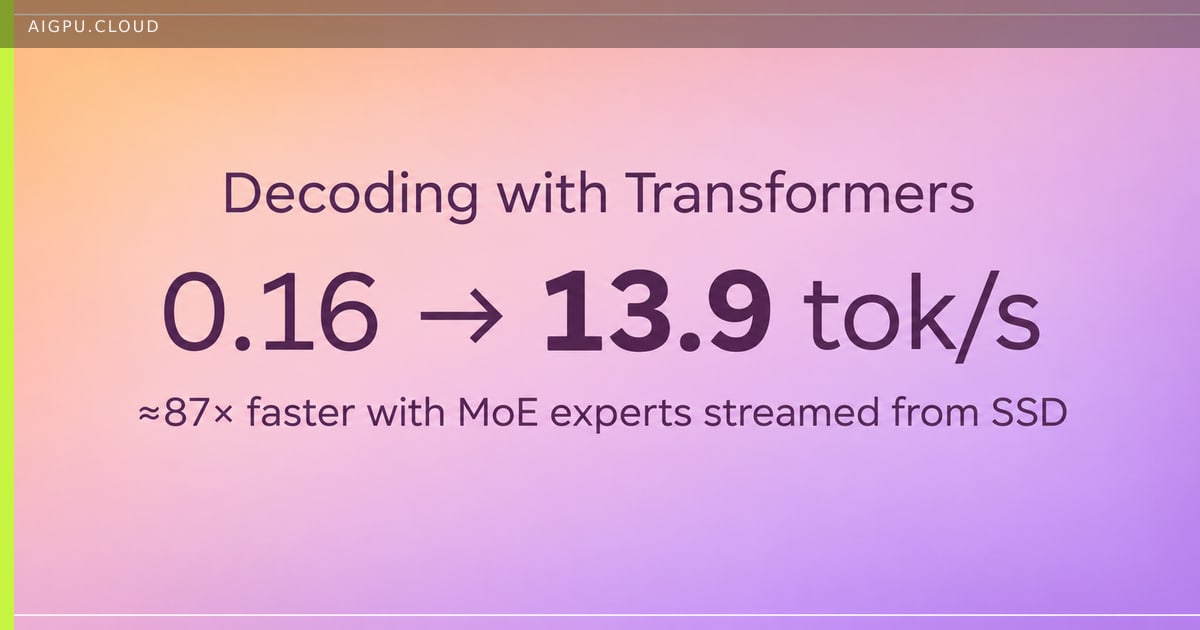
أثبت باحثون إمكانية تشغيل نموذج خليط خبراء (MoE) بحجم 180 مليار معامل على وحدة معالجة رسوميات واحدة بذاكرة 32 جيجابايت فقط، عبر بث أوزان الخبراء مباشرة من قرص SSD. تحتفظ الطريقة بالخبراء النشطين في ذاكرة VRAM بينما تُستدعى الخبراء الباردة عند الحاجة، محققة سرعات توليد رموز تفصلها 6 % فقط عن محرك مخصص مثل Strata.
لماذا هذا مهم للبنية التحتية لوحدات معالجة الرسوميات / الذكاء الاصطناعي
بالنسبة لمزودي الخدمات السحابية والمجموعات المحلية، يعني ذلك أن نماذج MoE الأكبر لم تعد تتطلب عقدًا متعددة لوحدات معالجة الرسوميات أو ذاكرة موحدة ضخمة. يمكن للمشغلين حزم المزيد من النماذج لكل وحدة معالجة رسوميات، تقليل نفقات رأس المال للأجهزة، مع الاستمرار في تقديم استدلال منخفض زمن الوصول لمساعدي البرمجة والدردشة ومهام الاستدلال.
- تنتقل الخبراء الموجهون فقط عبر ناقل PCIe في كل خطوة، مما يقلل حركة البيانات.
- يضيف التخزين على SSD طبقة ذاكرة ثالثة دونThrashing لذاكرة الصفحة.
- متوافق مع خطوط أنابيب Transformers وAccelerate الحالية، مما يسهل التبني.
تعمل التقنية أيضًا على شرائح Apple Silicon حيث تشترك وحدة المعالجة المركزية والرسوميات في الذاكرة، لأن طبقة البث تتجاوز المسار التقليدي للنقل إلى وحدة المعالجة المركزية الذي لا يحرر مساحة على أنظمة الذاكرة الموحدة.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- moe
- inference
- gpu cloud
- expert streaming
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Hugging Face Blog)
→ كل المقالات