Industry·
مضيف الراديو الذكي كويوتك يوضح كيف يخدم الذكاء الصوتي الفوري المجتمعات
يقدم المضيف المشارك ثنائي اللغة من إنترفيجن (Entravision) تعليقاً ثقافياً أصيلاً حول الهجرة والحياة اليومية، مما يوضح متطلبات البنية التحتية للذكاء الصوتي القائم على الشخصية بزمن استجابة منخفض وعلى نطاق البث.
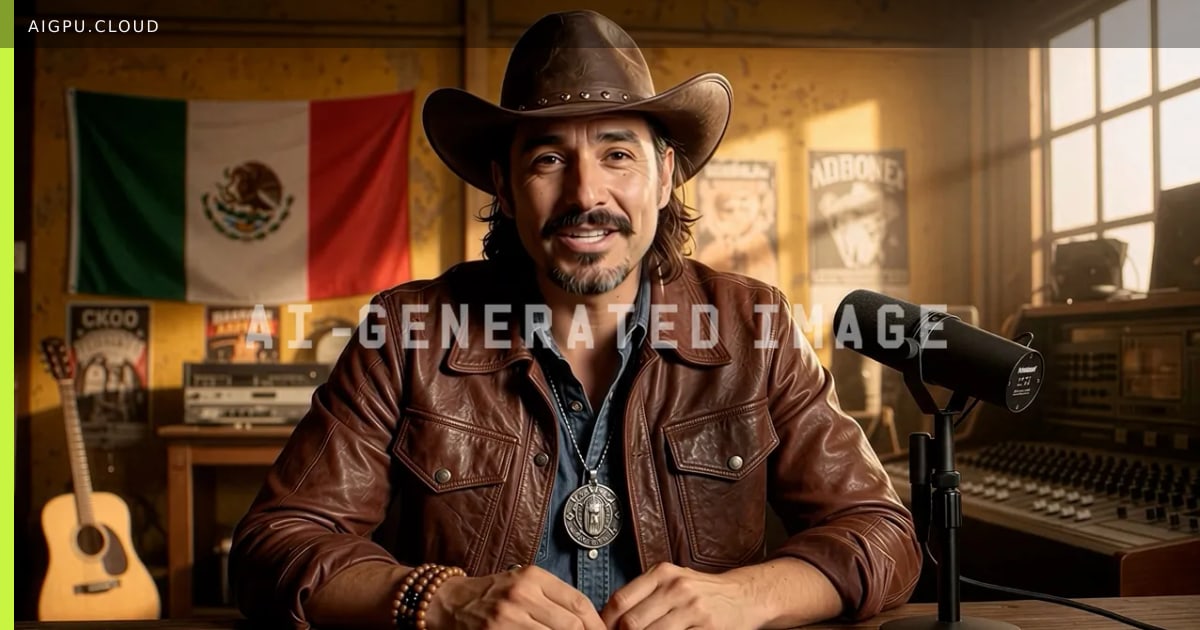
عندما أطلقت إنترفيجن (Entravision) كويوتك (Coyotec) على إذاعة خوسيه 97.5 إف إم (José 97.5 FM) في لوس أنجلوس، كان الهدف واضحاً: منح المستمعين اللاتينيين صوتاً يستطيع معالجة مداهمات الهجرة وحقوق العمال وحياة الحي دون تعريض المواهب البشرية لخطر قانوني. ما ظهر هو دراسة حالة في نشر الذكاء الصوتي ثنائي اللغة الغني بالشخصية بسرعة الراديو.
كويوتك لا يقرأ نصوصاً. إنه يتحادث بالسبانغلش (Spanglish)، ويستخدم مراجع ثقافية — بريا، جيفا، باريو — وينتقل بين نتائج مباريات الدودجرز وأدلة "اعرف حقوقك" في نفس الجملة. تأتي هذه الطلاقة من نموذج صوتي تم تدريبه على أنماط كلام منطقة الحدود، مدعوماً ببنية تحتية للاستنتاج تحافظ على زمن الاستجابة غير محسوس خلال فترات الذروة المباشرة.
لماذا يهم هذا البنية التحتية للذكاء الاصطناعي / وحدات معالجة الرسوميات
يتطلب التقديم المشترك في الوقت الفعلي خطوط أنابيب من الرمز إلى الصوت بأقل من 100 ميلي ثانية، وفصل متعدد المتحدثين، ونبرة صوتية متسقة عبر الجمل ذات التبديل الرمزي. تشغيل ذلك على مدار الساعة محلياً أو في سحابة خاصة يعني سعة وحدات معالجة رسوميات محجوزة، وأنوية تينسور محسنة لاستنتاج المبرمج الصوتي، وجدولة حتمية — وهو بالضبط ملف الحمل الذي صُممت مجموعات وحدات معالجة الرسوميات المعدنية (bare-metal) من AiGpu من أجله.
يواجه المذيعون الآن سؤال مشتريات جديد: ليس فقط "أي نموذج"، بل "أي بنية تحتية تضمن زمن الاستجابة ووقت التشغيل الذي يتوقعه الجمهور المباشر". تشير التقييمات المبكرة لكويوتك إلى أن المستمعين يبقون من أجل الأصالة، لكنهم يبقون فقط إذا لم يتقطع البث أبداً.
- aigpu
- ai gpu
- ai gpu cloud
- aigpu dubai
- voice ai
- real-time inference
- broadcast ai
- gpu infrastructure
بقلم AiGpu Editorial · إعادة صياغة تحريرية استناداً إلى تقارير عامة (Wired AI)
→ كل المقالات